ElevenLabs Scribe to model zamiany mowy na tekst (speech to text), który przepisuje nagrania audio i wideo w ponad 90 językach, w tym po polsku z błędem słów poniżej 5%. Aktualna wersja to Scribe v2 (styczeń 2026): rozpoznaje do 32 mówców, oznacza znaczniki czasu każdego słowa i eksportuje napisy SRT. Przez API godzina nagrania kosztuje 0,22 USD (ok. 0,84 zł), w aplikacji minuta zużywa 330 kredytów.
Wpis z lutego 2025 roku, gdy Scribe debiutował, przepisany w październiku 2026 roku na aktualne modele i ceny.
Wersje Scribe: v1, v2, Realtime i Medical
| Model | Premiera | Do czego | Status |
|---|---|---|---|
| Scribe v1 | 26.02.2025 | Pierwsza wersja, 99 języków | Wycofywany, zastąpiony przez v2 |
| Scribe v2 Realtime | 11.11.2025 | Transkrypcja na żywo, agenci głosowi, ok. 150 ms opóźnienia | Aktualny |
| Scribe v2 | 9.01.2026 | Długie i trudne nagrania: wywiady, podcasty, spotkania | Aktualny, domyślny w aplikacji |
| Scribe v2 Medical | 11.09.2026 | Nagrania kliniczne, o 35% mniej błędów niż v2 na takim materiale | Aktualny, tylko przez API |
W praktyce wybór jest prosty: plik do przepisania to Scribe v2, mowa na żywo (np. napisy do transmisji, rozmowa z botem) to Scribe v2 Realtime. Liczba „99 języków” z wielu starszych tekstów dotyczy Scribe v1. Dla v2 producent podaje „90+”.
Jak dokładnie Scribe przepisuje polski
W dokumentacji Scribe v2 polski jest w najwyższej klasie dokładności: WER do 5%, czyli najwyżej jedno błędnie rozpoznane słowo na dwadzieścia. W tej samej grupie są m.in. angielski, niemiecki, czeski i ukraiński. Osobnej liczby dla polskiego w v2 producent nie publikuje. Dla Scribe v1 podał wynik z testu FLEURS:
| Model | WER dla polskiego (FLEURS) |
|---|---|
| ElevenLabs Scribe v1 | 2,3% |
| Google Gemini Flash 2 | 3,8% |
| OpenAI Whisper Large v3 | 5,9% |
| Deepgram Nova 2 | 8,8% |
To dane producenta, z czytanego tekstu w dobrych warunkach. Na nagraniu z telefonu, z gwarem i nakładającymi się głosami błędów będzie więcej. Pomaga wtedy wcześniejsze oczyszczenie dźwięku w Voice Isolatorze i lista nazw własnych (keyterms), o której niżej. Nagranie, w którym mówi się kilkoma językami, nie wymaga dzielenia: model sam wykrywa zmianę języka.
Ile kosztuje Scribe: aplikacja kontra API
Tu jest największa pułapka. Te same pieniądze dają kilkanaście razy więcej godzin transkrypcji przez API niż w aplikacji, bo w aplikacji minuta zużywa 330 kredytów ze wspólnej puli, a API rozlicza się stawką 0,22 USD za godzinę. Ceny producenta z października 2026 roku, kurs 3,80 zł:
| Plan | Cena / mies. | Transkrypcja w aplikacji | Transkrypcja przez API |
|---|---|---|---|
| Free | 0 USD | 12 minut (wg producenta) | ok. 4 h 30 min |
| Starter | 6 USD (ok. 23 zł) | 1 h 31 min | ok. 27 h |
| Creator | 22 USD (ok. 84 zł) | 6 h 7 min | ok. 100 h |
| Pro | 99 USD (ok. 376 zł) | 30 h 18 min | ok. 450 h |
Godziny w aplikacji zakładają, że cała miesięczna pula idzie na Scribe. Jeśli w tym samym miesiącu generujesz lektora AI, minut ubywa. Przez API dopłaca się za dodatki: keyterms 0,05 USD/h, edycję transkrypcji poleceniem 0,07 USD/h. Scribe v2 Realtime kosztuje 0,39 USD za godzinę (ok. 1,48 zł). Pełne progi wszystkich planów są w cenniku ElevenLabs w złotówkach.
Wniosek: kto przepisuje kilka nagrań w miesiącu, zmieści się w aplikacji. Kto przepisuje podcasty lub archiwum nagrań w setkach godzin, powinien użyć API nawet bez programowania, np. przez gotowe narzędzia no-code lub prosty skrypt.
Jak zrobić transkrypcję w Scribe krok po kroku
- Zaloguj się na koncie ElevenLabs i otwórz zakładkę Speech to Text. Kliknij Transcribe files.
- Wgraj plik audio lub wideo (do 3 GB, do 10 godzin) albo wklej link do filmu z YouTube lub TikToka.
- Wybierz język Polish albo zostaw Detect, żeby model rozpoznał go sam.
- Opcjonalnie włącz Tag audio events (śmiech, oklaski w nawiasach) i dodaj keyterms: nazwiska, nazwy firm, terminy branżowe.
- Kliknij Upload files, a po przetworzeniu nazwę pliku. Kliknięcie słowa odtwarza nagranie od tego miejsca, więc poprawki robi się szybko.
- W prawym górnym rogu wybierz Export i format: tekst, SRT lub VTT do napisów, JSON albo HTML.
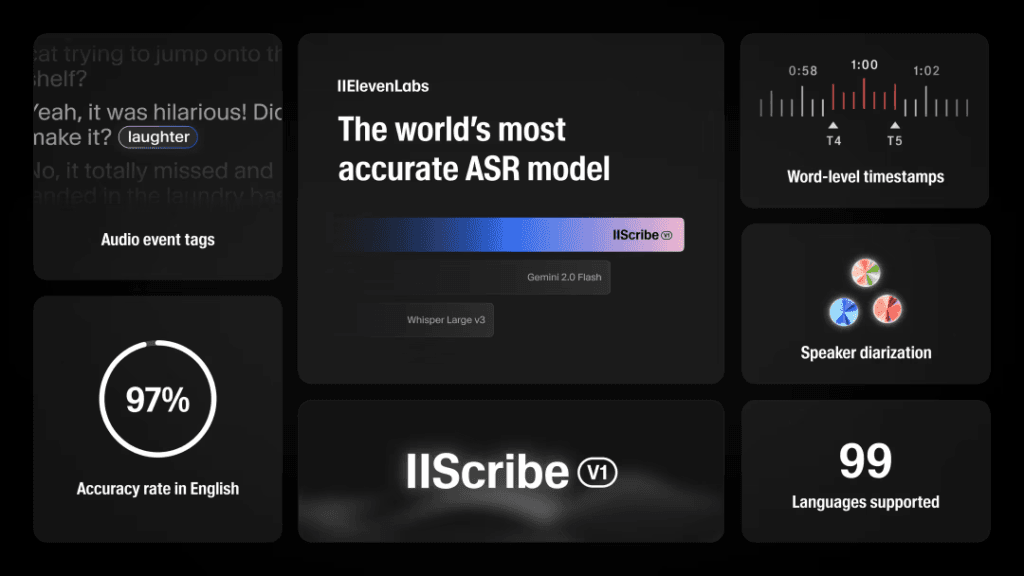
Funkcje Scribe v2
| Funkcja | Szczegóły | Gdzie |
|---|---|---|
| Rozpoznawanie mówców (diaryzacja) | Do 32 osób w jednym nagraniu | Aplikacja i API |
| Znaczniki czasu | Dla każdego słowa, opcjonalnie dla znaku | Aplikacja i API |
| Zdarzenia dźwiękowe | (śmiech), (oklaski), (kroki) w tekście | Aplikacja i API |
| Keyterms | Do 1 000 słów i fraz, które model ma rozpoznać poprawnie | Aplikacja i API |
| Tryb bez wypełniaczy | Usuwa „yyy”, powtórzenia i urwane początki zdań | API |
| Wykrywanie i ukrywanie danych | 65 typów encji, m.in. dane osobowe, medyczne i kart płatniczych | Tylko API |
| Wiele kanałów | Do 5 ścieżek, każda rozliczana osobno | API |
| Role mówców | Podział na „agent” i „klient” w nagraniach z infolinii (+10% ceny) | API |
| Eksport | TXT, SRT, VTT, JSON, HTML; przez API także DOCX i PDF | Aplikacja i API |
Scribe v2 robi też napisy w ElevenLabs Studio. Jeśli przygotowujesz film do dubbingu na inne języki albo nagranie audiobooka, transkrypcja powstaje w tym samym miejscu.
Scribe v2 Realtime: transkrypcja na żywo
Wersja Realtime zwraca pierwsze słowa po ok. 150 ms (bez opóźnienia sieci) przez WebSocket. Przewiduje też kolejne słowo i interpunkcję, a w trakcie rozmowy przełącza się między językami. Działa w ElevenAgents i przez API, więc służy głównie do budowy agentów głosowych i napisów na żywo. Dokumentacja nie wymienia przy niej rozpoznawania mówców. Do protokołu ze spotkania z podziałem na osoby lepiej nagrać całość i przepuścić przez zwykły Scribe v2.
Scribe przez API
Endpoint POST https://api.elevenlabs.io/v1/speech-to-text przyjmuje plik albo link (source_url, także YouTube) i zwraca JSON z tekstem, słowami, znacznikami czasu i identyfikatorami mówców. Klucze, limity i SDK opisujemy w poradniku ElevenLabs API.
curl -X POST https://api.elevenlabs.io/v1/speech-to-text \
  -H "xi-api-key: TWOJ_KLUCZ" \
  -F "model_id=scribe_v2" \
  -F "language_code=pol" \
  -F "diarize=true" \
  -F "[email protected]"
Pliki dłuższe niż 8 minut Scribe dzieli wewnętrznie na maksymalnie cztery części i przetwarza równolegle, więc godzinne nagranie wraca po kilku minutach, a nie po godzinie. Wyniki dla długich plików można odbierać asynchronicznie przez webhook.
Ograniczenia i prywatność
- Dane są domyślnie przechowywane. Tryb bez zapisywania (Zero Retention Mode) jest tylko dla klientów Enterprise i tylko przez API. Nagrania wgrane w aplikacji nie są nim objęte.
- Plan Free to użytek prywatny. Licencja komercyjna zaczyna się od planu Starter.
- Działa tylko w chmurze. Wdrożenia lokalne (on-premise) są dostępne wyłącznie w ofercie Enterprise.
- Medical nie zastępuje lekarza. Producent zastrzega, że model nie interpretuje danych klinicznych i tekst musi sprawdzić specjalista.
- Nagrania słabej jakości wymagają korekty. Przesterowany dźwięk i kilka osób mówiących naraz obniżają dokładność bardziej niż sam język.
Scribe najłatwiej sprawdzić na własnym nagraniu: darmowe konto ElevenLabs wystarczy na krótki wywiad albo fragment podcastu, zanim zdecydujesz o planie lub API.
FAQ — ElevenLabs Scribe
Tak. W dokumentacji Scribe v2 polski jest w najwyższej klasie dokładności, z błędem słów (WER) do 5%. Model rozpoznaje też nagrania, w których mówi się kilkoma językami.
W planie Free można przepisać ok. 12 minut nagrań miesięcznie (według producenta), wyłącznie do użytku prywatnego. Przez API Scribe v2 kosztuje 0,22 USD za godzinę, czyli ok. 0,84 zł.
W aplikacji 1 h 31 min miesięcznie (330 kredytów za minutę). Przez API te same 6 USD wystarczają na ok. 27 godzin.
Tak. Transkrypcję eksportuje się do SRT lub VTT ze znacznikami czasu, a w ElevenLabs Studio Scribe v2 generuje napisy bezpośrednio do projektu.
Tak. W aplikacji i przez API (parametr source_url) można podać link do YouTube, TikToka lub innego serwisu wideo zamiast wgrywać plik.
Do 3 GB i do 10 godzin nagrania w trybie standardowym. Minimalna długość to 100 ms.
Scribe v2 rozpoznaje do 32 mówców w jednym nagraniu i przypisuje im fragmenty tekstu. Wersja Realtime według dokumentacji tej funkcji nie ma.